Zašto samo jedan kubit do sada?
Videli smo do sada šta sve jedan kubit podrazumeva. Na jednom kubitu gradimo intuiciju i tehničke alate koji su na potrebni kasnije u slučaju višekubita. Treba napomenuti da neki od intuitivnih stvari poput Blohove sfere ne može da se iskoristi u sistemima višekubita.
Ono gde zapravo kvantni računari su od koristi jeste slučaj kad ih je više i kad oni mogu da deluju jedan na drugog i podležu kvantnim kapijama ne-lokalnog dejstvar (dva, tri i itd kvantne kapije). Svi kvantni algoritmi uključuju više od jednog kubita.
Treba isto navesti nedavni primer korisnosti jednog kubit sistema u procesuiranju klasičnih signala:
sa pratećim radom na https://
arxiv .org /pdf /2608 .13521
Što govori da već ovo što smo do sad obradili može biti osnova naučnog delovanja u odgovarajućem kontekstu.
Višekubitna računska baza
Registar od kubita živi u prostoru dimenzije , sa računskom bazom
Gde koristimo operaciju tenzorskog proizvod . Šta precizno tenzorski proizvod između dva vektora ili dve matrice čini možemo videti kroz račun ispod.
Prikaži račun (klik)
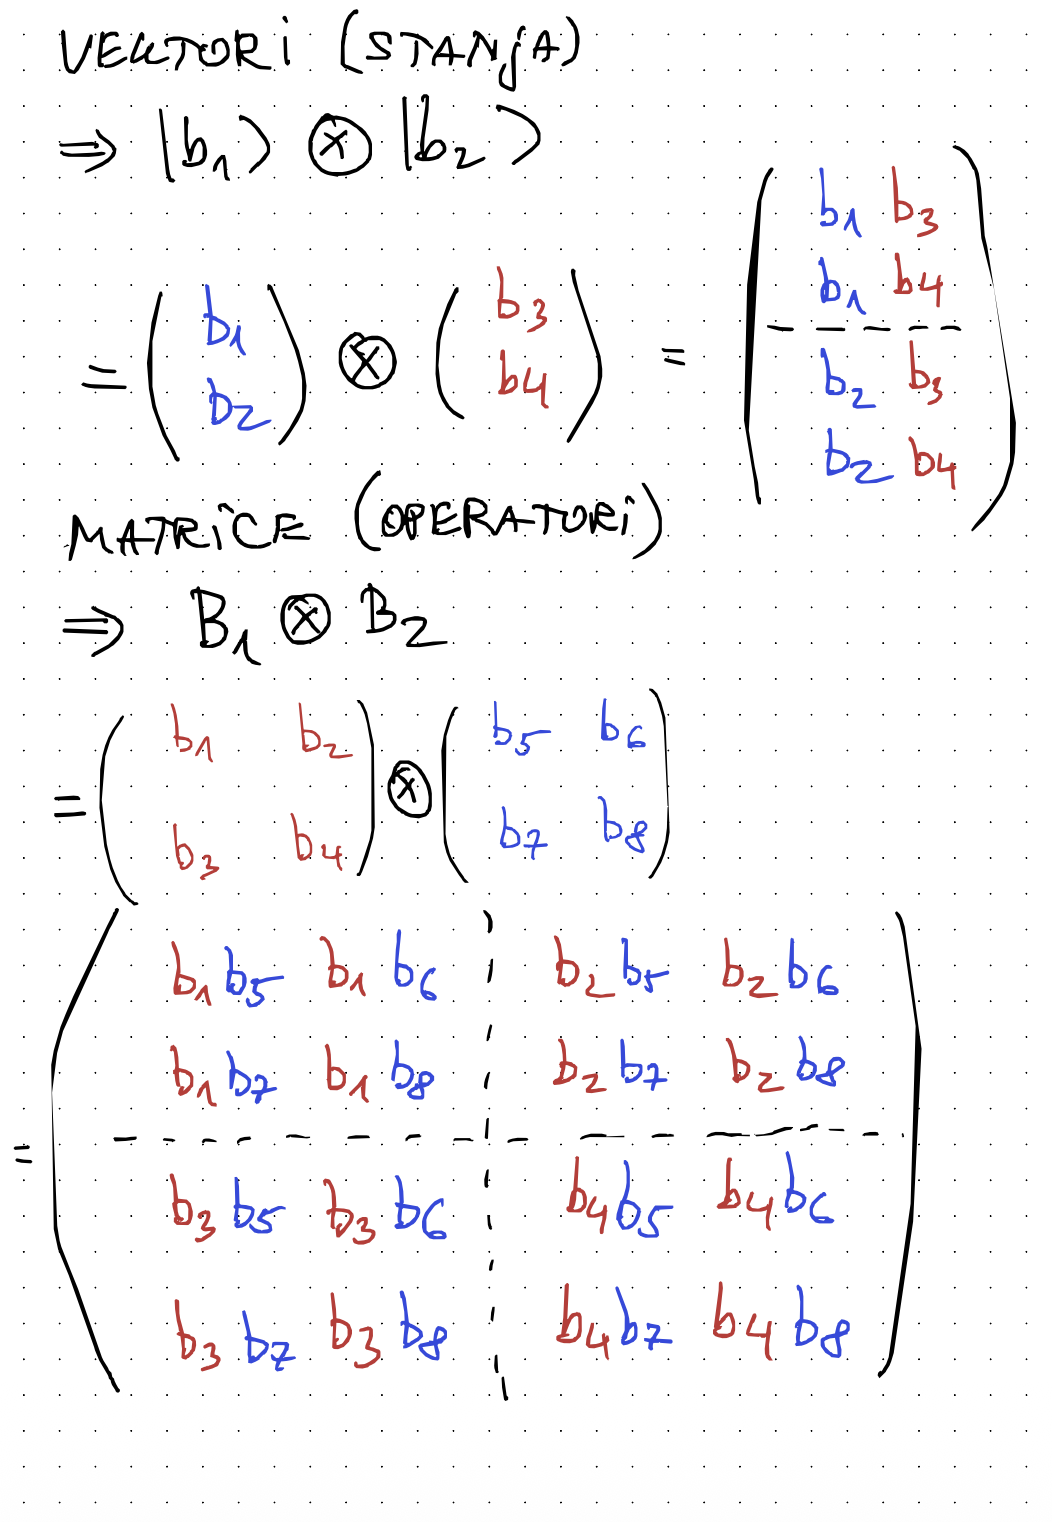
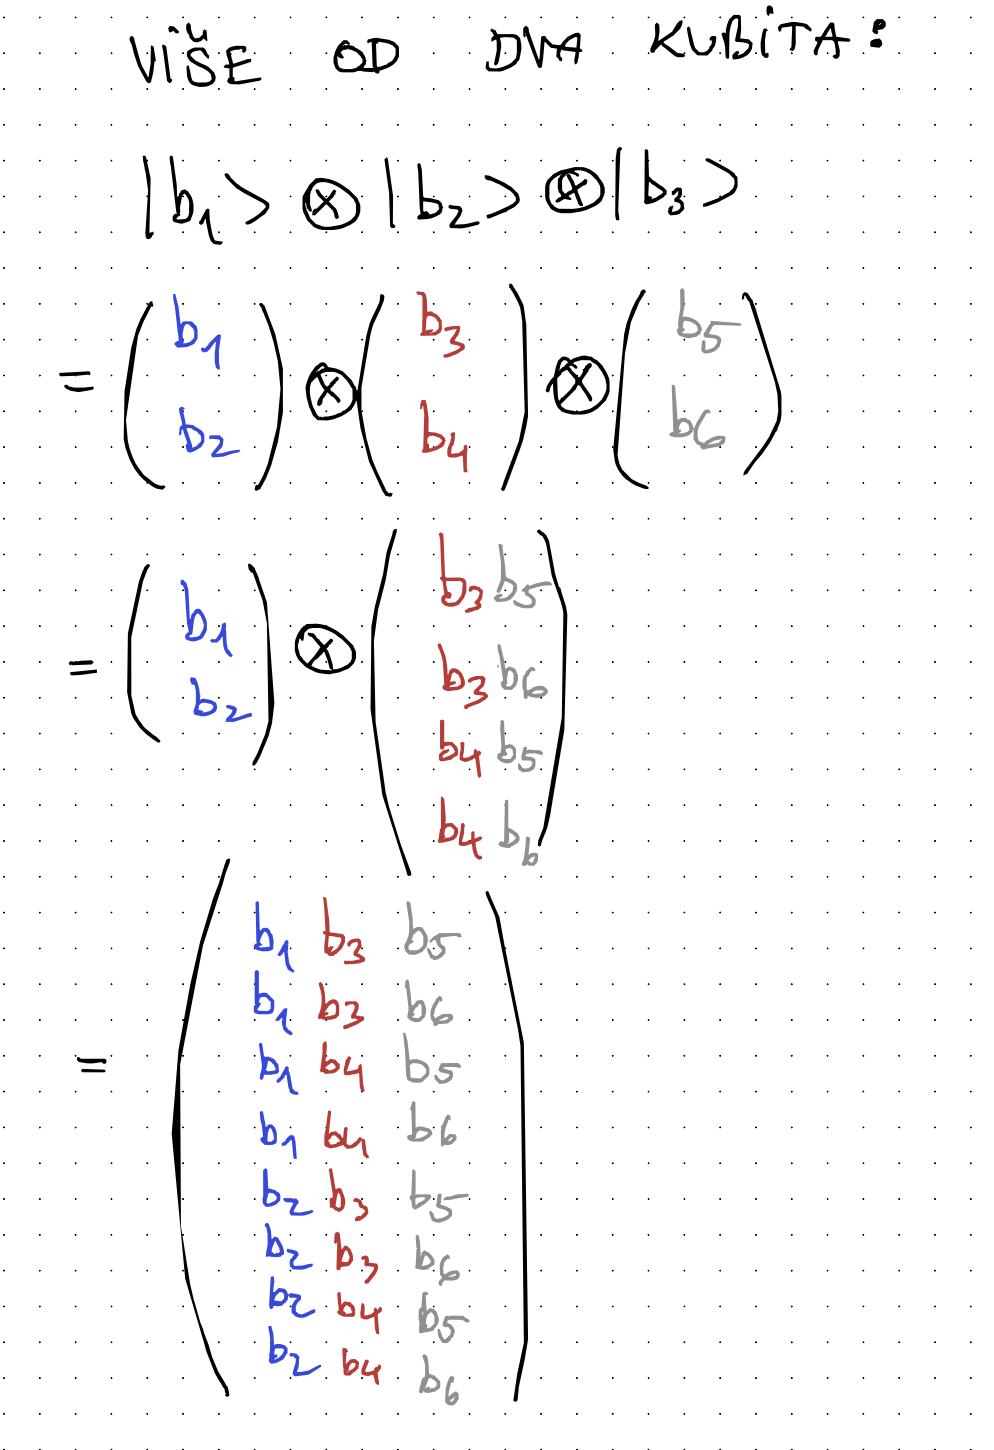
Koristeći Python takvu operaciju možemo koristiti na sledeći način:
import numpy as np

# Primer 1: tenzorski proizvod vektora |0> i |1>
ket0 = np.array([1, 0])
ket1 = np.array([0, 1])
vektor = np.kron(ket0, ket1)
print("|0> ⊗ |1> =", vektor)          # [0 1 0 0]
print("oblik vektora:", vektor.shape)  # (4,)

# Primer 2: tenzorski proizvod dve matrice
X = np.array([[0, 1], [1, 0]])
Z = np.array([[1, 0], [0, -1]])
matrica = np.kron(X, Z)
print("X ⊗ Z =\n", matrica)
print("oblik matrice:", matrica.shape)  # (4, 4)
Koliko memorije treba za kubita?
Iz gornjih primera vidimo ključnu osobinu tenzorskog proizvoda: on množi, a ne sabira dimenzije. Jedan kubit živi u prostoru dimenzije 2; kad dodamo još jedan, dimenzija ne postaje nego . Svaki novi kubit udvostručuje broj koeficijenata (amplituda) koje moramo da pamtimo, pa broj brojeva raste kao
Odatle sledi da za registar od kubita treba:
vektor stanja sa kompleksnih amplituda (jedan broj po baznom stanju), i
operator/matricu (npr. kvantnu kapiju na svih kubita) sa kompleksnih elemenata.
Dodavanje jednog kubita udvostručuje dužinu vektora, a učetvorostručuje broj elemenata matrice. To je suština „eksponencijalnog zida": pomak od do kubita znači puta veći vektor i puta veću matricu.
U numeričkim simulacijama kompleksnu amplitudu čuvamo kao par realnih brojeva (realni i imaginarni deo):
jednostruka preciznost (dva
float32): bajtova po amplitudi,dvostruka preciznost (dva
float64): bajtova po amplitudi.
Potrebna memorija je onda prosto broj elemenata puta broj bajtova po elementu:
Sledeća tabela daje memoriju potrebnu za čuvanje jednog vektora stanja od kubita (koristimo binarne jedinice: B, KiB, itd.):
| (kubita) | dimenzija | vektor, complex64 (8 B) | vektor, complex128 (16 B) |
|---|---|---|---|
| 1 | 2 | 16 B | 32 B |
| 10 | 1 024 | 8 KiB | 16 KiB |
| 20 | ~106 | 8 MiB | 16 MiB |
| 26 | ~ | 512 MiB | 1 GiB |
| 30 | ~109 | 8 GiB | 16 GiB |
| 34 | ~ | 128 GiB | 256 GiB |
| 40 | ~1012 | 8 TiB | 16 TiB |
| 45 | ~ | 256 TiB | 512 TiB |
| 50 | ~1015 | 8 PiB | 16 PiB |
Za matricu ( elemenata) je slika još drastičnija — ona „potroši" istu memoriju kao vektor sa dvostruko više kubita, jer :
| (kubita) | elemenata | matrica, complex64 (8 B) | matrica, complex128 (16 B) |
|---|---|---|---|
| 1 | 4 | 32 B | 64 B |
| 5 | 1 024 | 8 KiB | 16 KiB |
| 10 | ~106 | 8 MiB | 16 MiB |
| 15 | ~109 | 8 GiB | 16 GiB |
| 20 | ~1012 | 8 TiB | 16 TiB |
| 25 | ~1015 | 8 PiB | 16 PiB |
Nekoliko orijentira da brojevi dobiju smisao:
tipičan laptop sa RAM-a u dvostrukoj preciznosti staje do otprilike kubita za sam vektor stanja (a u praksi manje, jer i sistem i međurezultati troše memoriju),
već oko –50 kubita ulazimo u domen najjačih svetskih superračunara, gde vektor meri stotine terabajta do petabajta.
kod kubita broj amplituda 2300 premašuje procenjeni broj atoma u vidljivom svemiru, tj. takvo stanje je nemoguće ispisati, a kamoli sačuvati, ni na jednom klasičnom računaru
Opšte stanje je superpozicija svih baznih stanja,
gde prolazi kroz svih mogućih binarnih bitova sastavljenih od 0 i 1.
Eksplicitno:
gde je indeks uz svaku amplitudu prosto bitska niska pročitana kao binarni broj (npr. stoji uz jer je , računato od nule).
U Pythonu bitsku zapis u ceo broj (indeks) prevodimo jednom linijom pomoću ugrađene funkcije int(string, 2):
print(int("101", 2))    # 5
print(int("000", 2))    # 0
print(int("111", 2))    # 7
Dodatni indeksi
U literatura nekada indeksi koji su povezani sa kubitima su zapisani. Na primer za prethodno stanje koje smo definisali možemo napisati
Ovakav zapis nekad možda izgleda previše, ali u nekim situacijama je bitno pratiti redosled i indekse u računici.
Indeksiranje: bitski string kao redni broj
Kada stanje čuvamo kao vektor u , moramo znati koja komponenta odgovara kojoj bitskom stringu. Konvencija je jednostavna: string pročitamo kao binarni broj, i to je redni broj (indeks) odgovarajuće komponente,
Tako ide na indeks 0, a na indeks 7. Baš zato je uvek jedan jedinični vektor standardne baze — ima jednu jedinicu na mestu , a nule svuda drugde.
Rešenje
, pa je (šesti vektor, brojano od nule).
import numpy as np
ket0 = np.array([1, 0], dtype=complex)
ket1 = np.array([0, 1], dtype=complex)

psi = np.kron(np.kron(ket1, ket0), ket1)      # |1> ⊗ |0> ⊗ |1>
print("indeks 101 =", int("101", 2))          # 5
print("|101> == e_5 ? ", np.allclose(psi, np.eye(8)[5]))
Jovan Odavić · dzovan90 [at] gmail [dot] com · www.jovanodavic.com